SDN Cisco DCNM + iTRACS
Nexus para la red de datos, MDS para el Fibre Channel. Dos redes que sostienen tu data center, ahora con ubicación física, estado real y alarmas; todo en un solo plano.
QUÉ ESTAMOS INTEGRANDO
Monitorización y traslado de métricas y de switches.
SISTEMAS INTEGRADOS
Cisco DCnM + iTRACS DCiM.
RESULTADO PRINCIPAL
Datos reales de todo el fabric del data center (Nexus para LAN y MDS para Fibre Channel) en el DCiM.
Contexto de la integración
iTRACS DCiM ON PREMISE
Fabricante: iTRACS
Versión: iTRACS DCiM según entorno del cliente
Módulos: iTRACS CI API REST
Cisco DCNM ON PREMISE
Fabricante: Cisco
Versión: Cisco DCNM según entorno del cliente
Módulos: API REST
Node Red ON PREMISE
Fabricante: Node Red
El reto: ¿por qué era necesaria esta integración?
- El fabric del data center es el punto de fallo más silencioso y más devastador. Cuando cae un switch Nexus de core o un MDS de Fibre Channel, no se pierde un enlace de red, se pierde la conectividad de decenas o cientos de servidores a la red, al almacenamiento, o a ambos, pero el equipo de infraestructura física necesita saber en qué rack, en qué unidad y con qué cableado está ese switch para actuar. Sin integración, la traducción de "alarma en DCNM" a "intervención física en la sala" depende de documentación manual que rara vez está actualizada en el momento de la crisis.
- Visibilidad de la red SAN (Fibre Channel) ausente del inventario físico. Los switches MDS gestionan la red de almacenamiento, la conexión entre servidores y cabinas de discos. Son equipos que viven en el data center pero que habitualmente solo el equipo de storage conoce y gestiona. El DCiM tiene registrados los servidores y el almacenamiento, pero el fabric que los conecta (los MDS, sus puertos, su capacidad, su estado) es una zona ciega. Integrar DCNM cierra esa brecha: cada switch de Fibre Channel aparece en el DCiM con su ubicación, su estado operativo, su capacidad de puertos y sus alarmas, dando visibilidad completa a una capa que hoy es invisible para la gestión de infraestructura.
- Capacidad de puertos del fabric sin contexto de crecimiento físico. DCNM sabe cuántos puertos de cada Nexus y cada MDS están ocupados vs. disponibles. Pero no sabe si en ese rack hay espacio para añadir un switch más, si la PDU soporta más carga, o si el cableado de patch panel tiene puertos libres. La decisión de "dónde poner el nuevo switch" se toma sin información física real. La integración permite planificar el crecimiento del fabric cruzando datos de capacidad lógica (DCNM) con capacidad física (DCiM).
- Dos mundos de gestión que no se hablan: red de datos y red de almacenamiento en silos. En un data center, el equipo de redes gestiona los Nexus en DCNM, el equipo de storage gestiona los MDS (a veces en otra instancia de DCNM o en herramientas de SAN), y el equipo de infraestructura gestiona la ubicación física en el DCiM. Tres equipos, tres herramientas, tres visiones parciales del mismo CPD. Integrar DCNM con el DCiM crea por primera vez una vista unificada donde el fabric completo del data center — LAN y SAN — tiene presencia en el mapa físico con datos operativos reales. Esto es especialmente valioso en entornos con múltiples CPDs (como las dos sedes del Ministerio de Justicia) donde la dispersión de información se multiplica.
La integración responde a la necesidad de disponer en iTRACS DCiM de información procedente de la plataforma Cisco DCNM, evitando la introducción o actualización manual de los valores monitorizados.
- Integración entre plataformas: conexión entre Cisco DCNM e iTRACS DCiM mediante sus respectivas APIs REST.
- Sincronización de activos: identificación automática del mismo switch en ambas plataformas mediante IP, número de serie y nombre.
- Gestión de relaciones: mantenimiento de un fichero de relaciones que permite reutilizar las correspondencias identificadas en la siguientes ejecuciones.
- Gestión de logs: generación de logs de las acciones realizadas durante cada ciclo para facilitar la detección y resolución de errores.
- Frecuencia de ejecución configurable: ejecución del proceso cada 15 minutos por defecto, pudiendo adaptarse a las necesidades del cliente.
Los sistemas del ecosistema
SISTEMA | DESCRIPCIÓN | APORTA | RECIBE |
Cisco DCNM | Plataforma de gestión y monitorización de la infraestructura de red Cisco. | Información de los switches monitorizados. | Nada. |
iTRACS | Plataforma de gestión de infraestructura de centro de datos (DCiM). | Almacenamiento de los datos obtenidos de la plataforma de Cisco DCNM. | Valores obtenidos de la plataforma Cisco DCNM. |
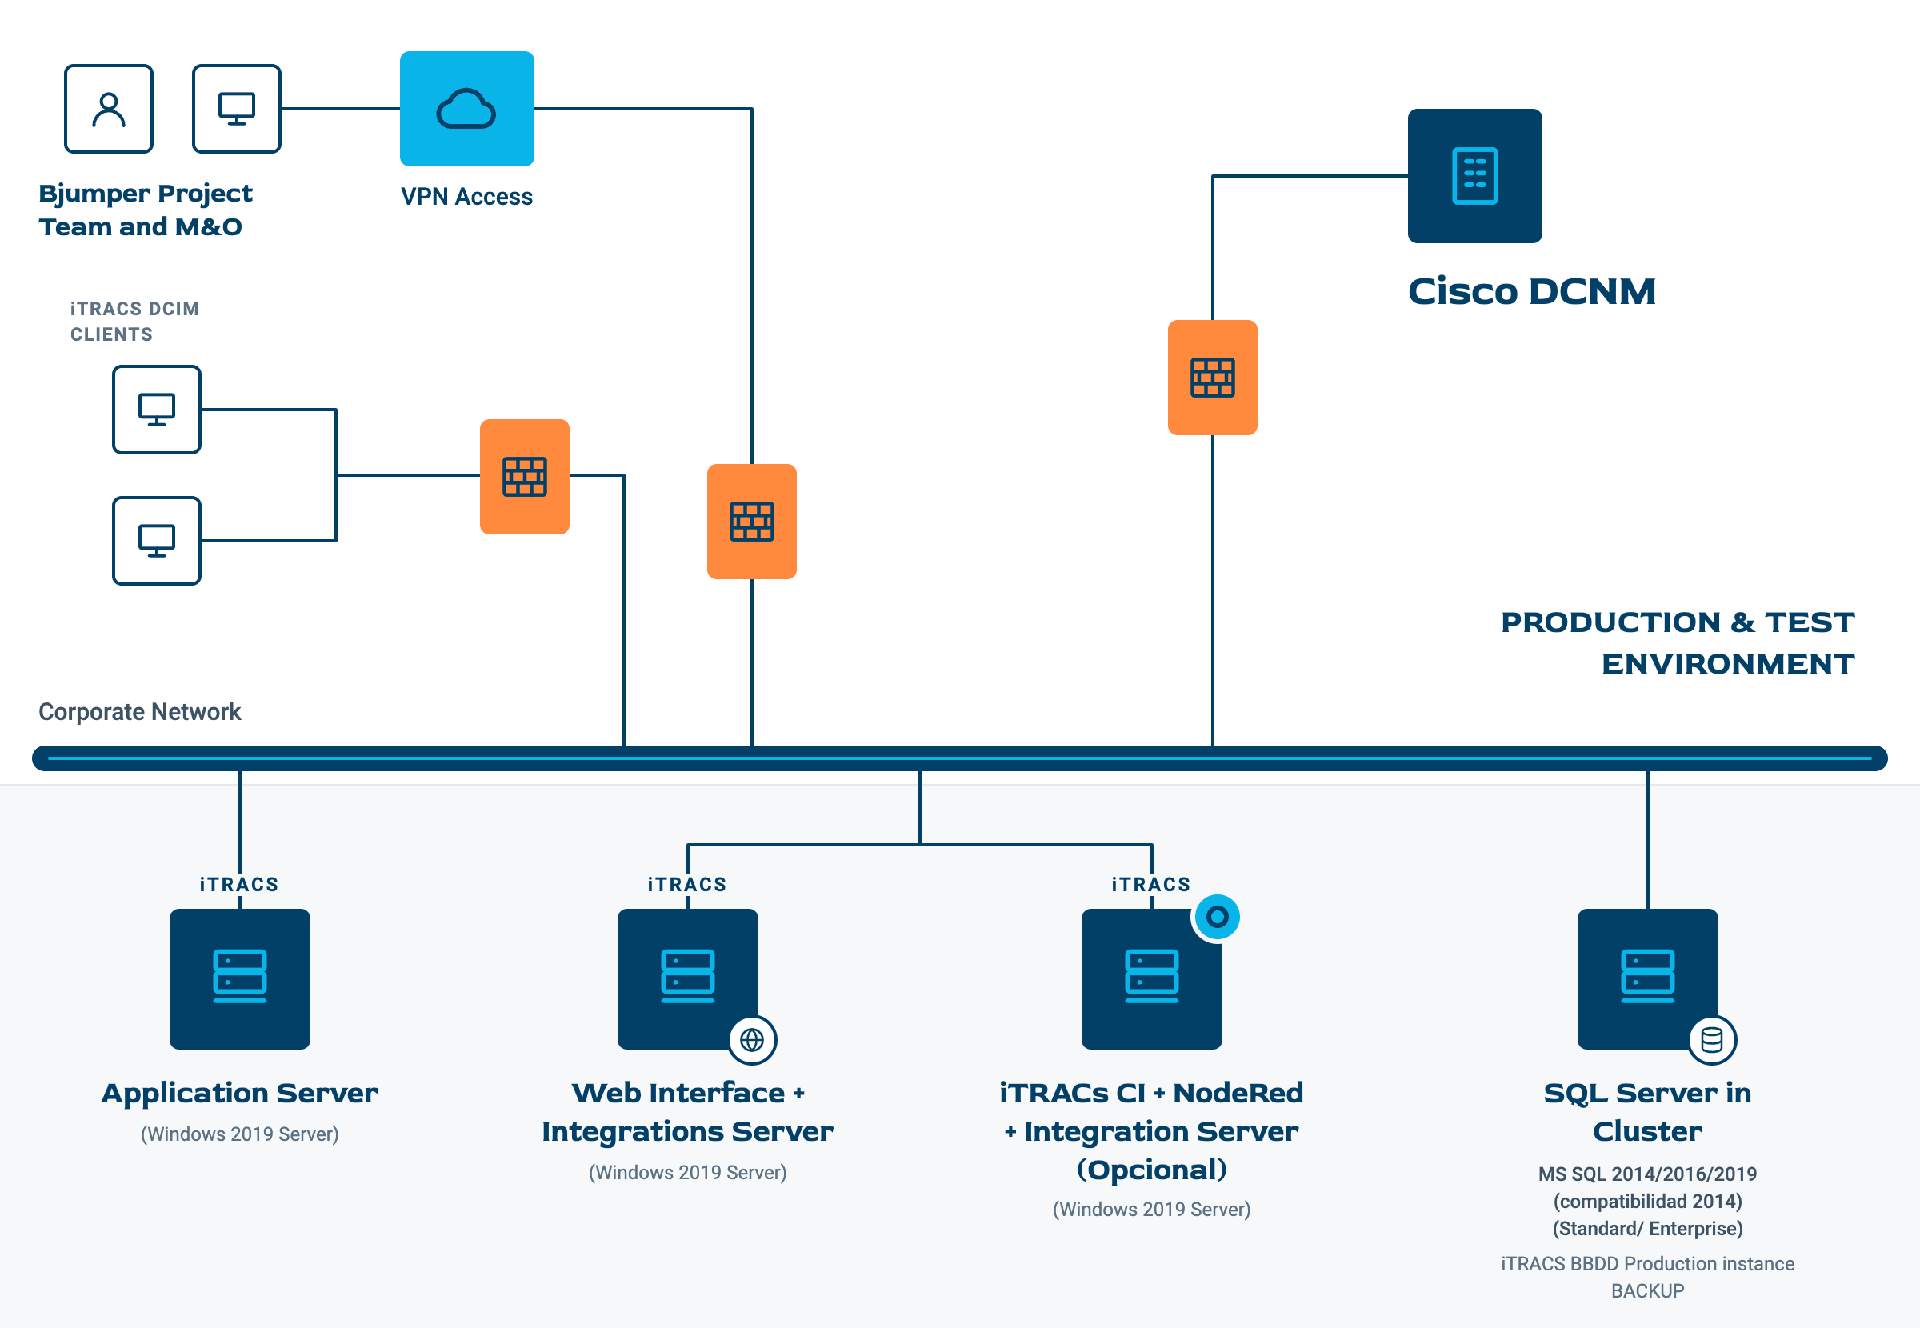
El diagrama de conexión
La arquitectura está compuesta por dos sistemas externos (Cisco DCNM y iTRACS) y un servidor de integraciones que contiene un flujo de NodeRed, desplegada en un servidor Windows.
El flujo de datos en acción
Flujo de monitorización: de Cisco DCNM a iTRACS DCiM
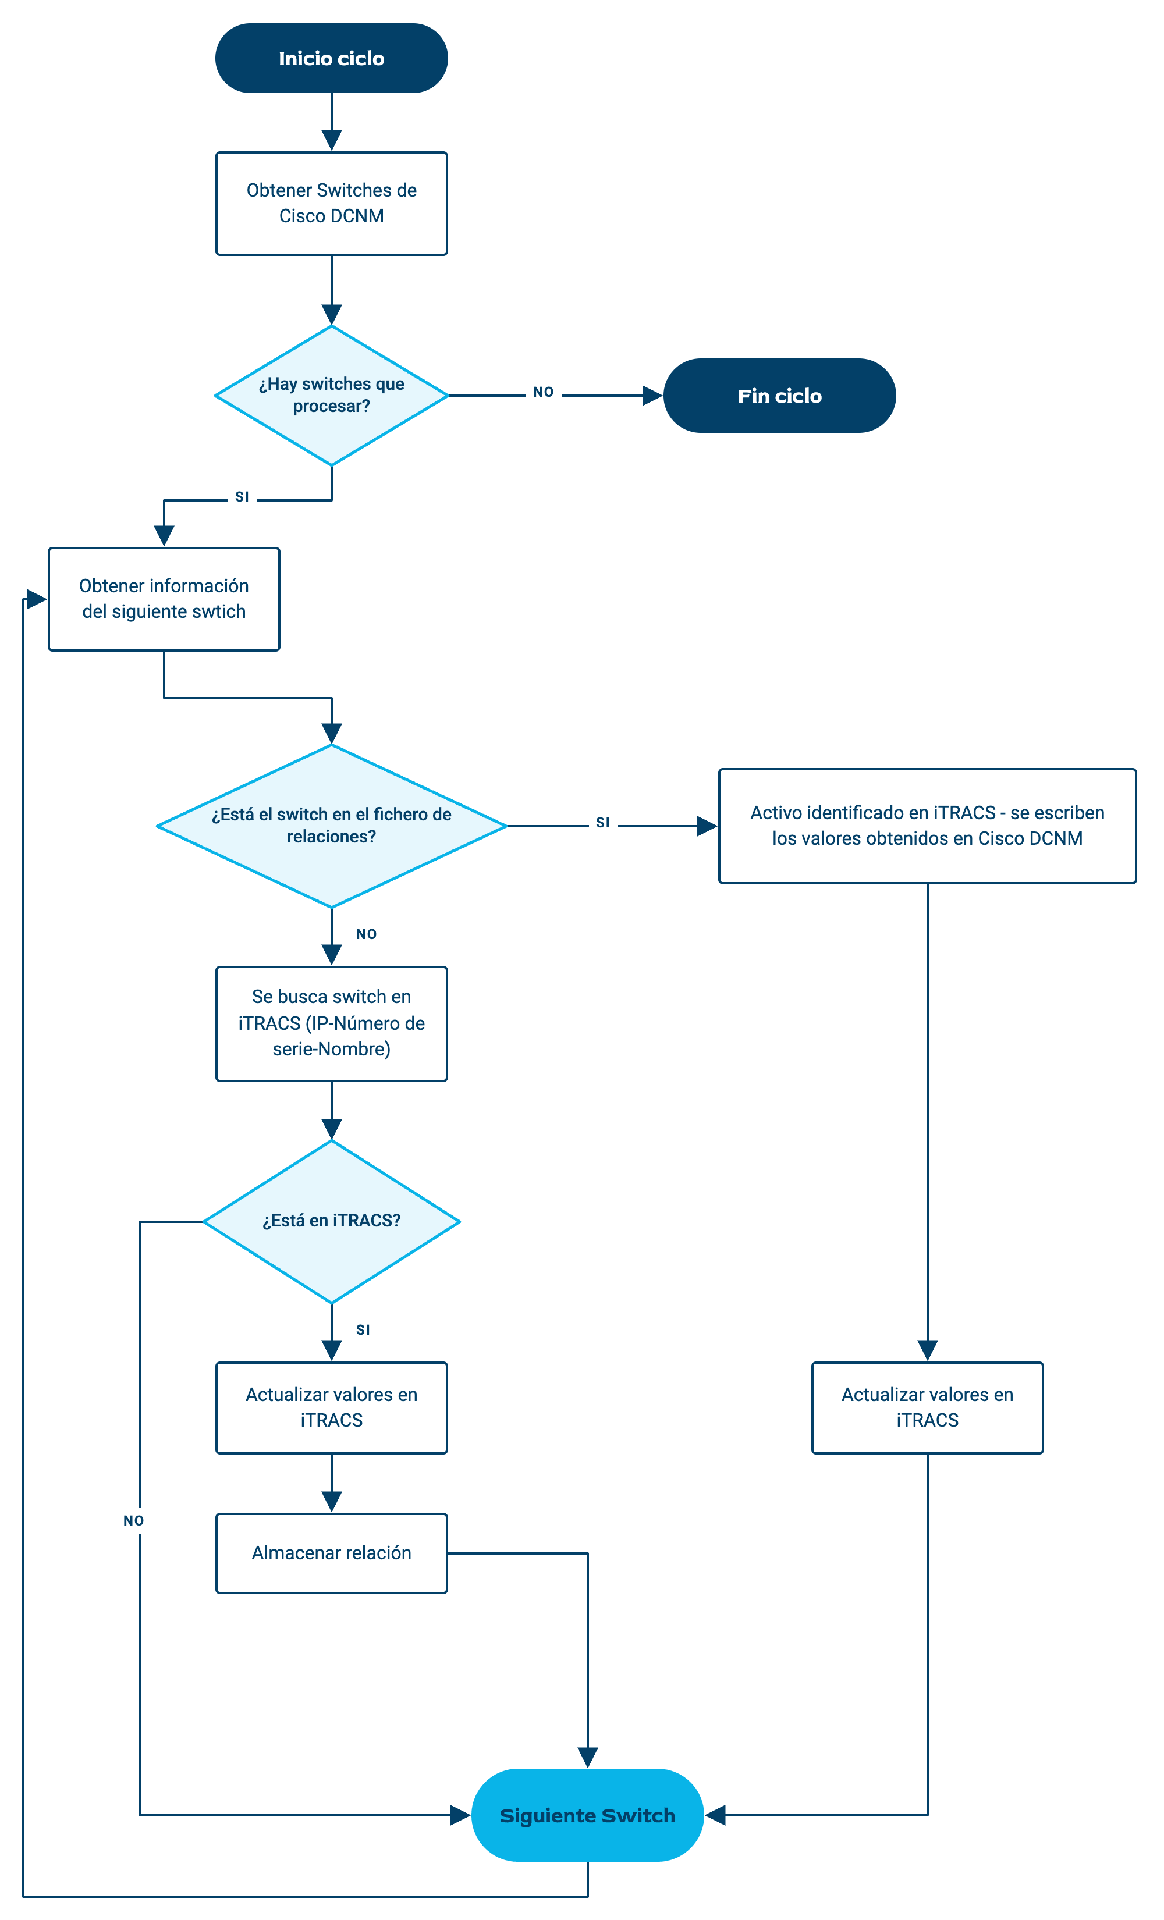
Inicio del ciclo
Node-RED inicia una nueva ejecución del proceso según la frecuencia configurada.
El flujo realiza una consulta mediante la API REST de Cisco DCNM para obtener los switches monitorizados y la información disponible de cada dispositivo.
Selección de información
De la información obtenida se seleccionan únicamente aquellos valores monitorizados que sean relevantes para el proyecto y que deban ser trasladados a iTRACS DCiM.
Identificación del activo
Para cada switch obtenido de Cisco DCNM se busca su activo equivalente en iTRACS DCiM. La búsqueda se realiza siguiendo el siguiente orden:
a. IP.
b. Número de serie.
c. Nombre.
Cuando el activo es localizado, se registra la correspondencia entre ambos sistemas, incluyendo la información necesaria para identificar el activo de Cisco DCNM y su correspondiente activo en iTRACS.
Escritura en iTRACS
NodeRed utiliza la API REST de iTRACS CI para escribir los valores monitorizados en los datastores correspondientes del activo.
Las operaciones realizadas durante el ciclo quedan registradas en los ficheros de log.
Siguiente iteración
En la siguiente ejecución se reutiliza el fichero de relaciones para evitar realizar nuevamente la búsqueda completa de los activos en iTRACS.
VOLUMEN
El volumen de datos dependerá del número de switches monitorizados y de los valores seleccionados para su traslado a iTRACS.
FRECUENCIA
Ejecución periódica configurable para cada cliente.
Diagrama de flujo de datos
Lo que hizo la diferencia
Decisiones de diseño que no eran las obvias, y por qué las tomamos.
Clave 2: sistema de log
Se incorporó un sistema de log que registra las operaciones realizadas durante cada ciclo y permite identificar posibles errores.
Clave 1: mapeo automática de activos
Se diseñó un mecanismo de mapeo automático entre los activos de Cisco DCNM e iTRACS DCiM utilizando un orden de búsqueda por IP, número de serie y nombre.
Además, una vez encontrada la correspondencia, esta se almacena en un fichero de relaciones, evitando repetir en cada ciclo la búsqueda completa en iTRACS.
¿Hablamos de tu integración?
Cuéntanos qué sistemas tienes y qué necesitas que se hablen.