El inventario virtual de VMware aterrizado en el rack, siete vCenter en un solo iTRACS
Más de 50 variables de cada VM y cada hypervisor, desde el uso de CPU hasta la VLAN, aterrizadas en el rack exacto donde vive el servidor físico.
QUÉ ESTAMOS INTEGRANDO
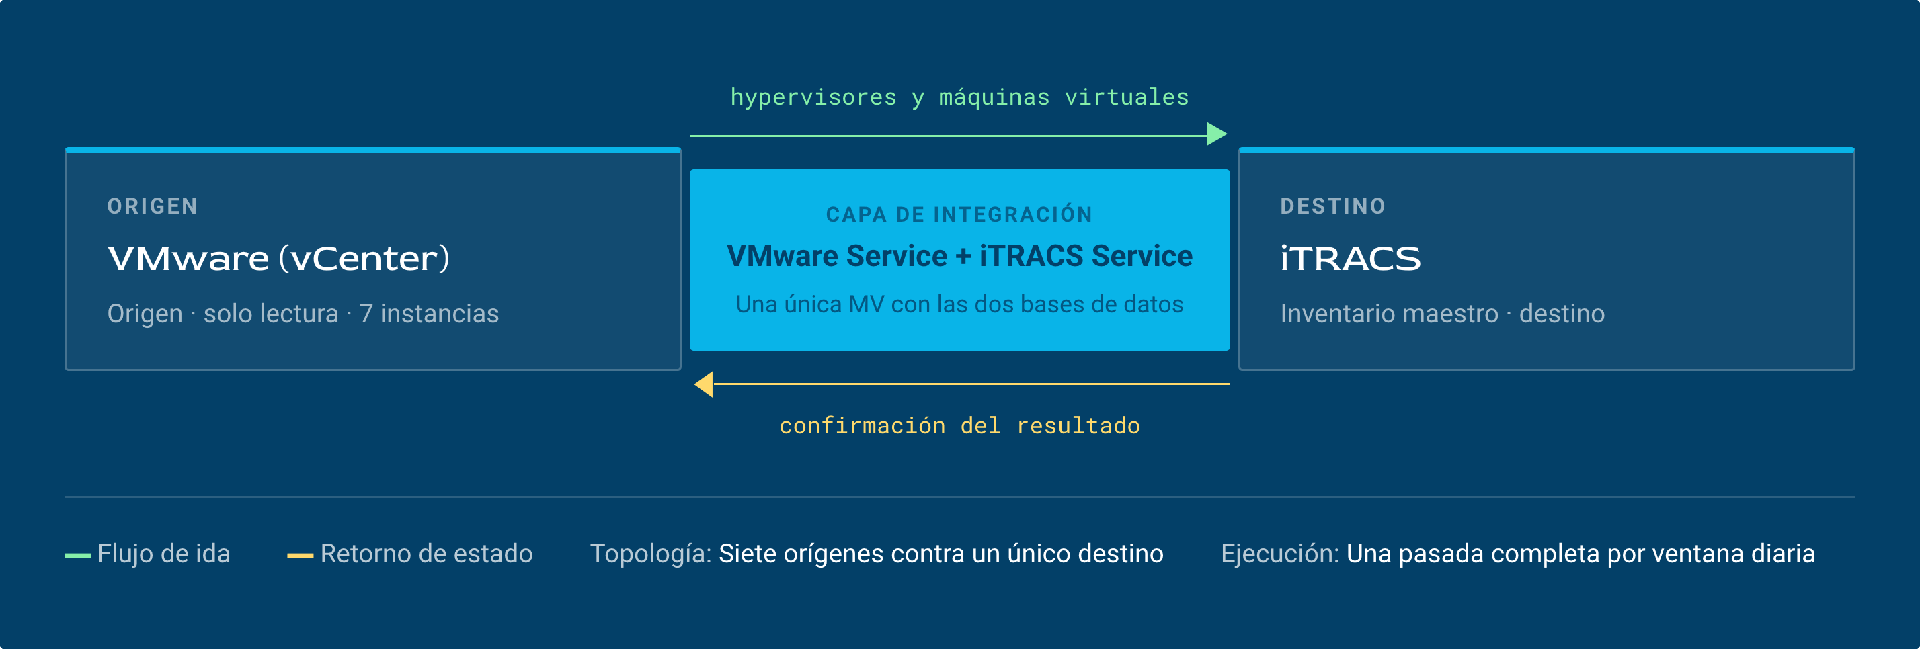
Relaciones entre hipervisores y máquinas virtuales y los servidores en los que se ejecutan. En nuestro caso de éxito, estamos integrando los datos de 7 instancias de VMWare, algunas con miles de máquinas virtuales, en un solo DCiM.
SISTEMAS INTEGRADOS
VMWare + ITRACs
RESULTADO PRINCIPAL
Conocer qué servicios se ejecutan en qué máquinas, para prevenir caídas o errores al tener dos silos de conocimiento separados (infra física y virtualización)
Contexto de la integración
iTRACS ON PREMISE
API con la que trabaja la integración:
- iTRACS API REST V24.3
Despliegue:
- Python 3.10
- Django 5.0 + Django REST Framework
- PostgreSQL 13 nativos en la MV
- Servicio con Gunicorn + Nginx
VMware ON PREMISE
API con la que trabaja la integración:
- vSphere Web Services API 8.0 U3
Desplegado en contenedores Docker - un contenedor por vCenter (13 actualmente)
- Python 3.10
- FastAPI 0.112.0
- PostgreSQL 13
- Servicio con Uvicorn (servidor ASGI)
El reto: ¿por qué era necesaria esta integración?
- Desconexión total entre el inventario virtual y el inventario físico. El equipo de virtualización gestiona cientos o miles de VMs en vCenter, mientras el equipo de infraestructura gestiona los activos físicos en el DCiM. Cuando alguien pregunta "¿en qué rack está el servidor que ejecuta esta VM crítica?", la respuesta requiere cruzar manualmente dos sistemas que no se hablan. Esto se convierte en un cuello de botella operativo con cada incidencia, cada auditoría y cada cambio planificado.
- Imposibilidad de detectar servidores zombies y optimizar la capacidad. Sin integración, no existe una forma automatizada de cruzar el consumo real de recursos de las VMs (CPU, memoria, disco) con la ubicación física y la capacidad disponible del rack. Las VMs abandonadas ("zombies") siguen consumiendo energía, licencias y espacio sin que nadie lo detecte, porque el dato de uso vive en vCenter y el dato de coste físico vive en el DCiM.
- Planificación de capacidad a ciegas. Cuando se necesita desplegar nuevas VMs o consolidar hypervisores, la decisión de "dónde poner la carga" se toma sin visibilidad del impacto en la infraestructura física (energía disponible en el rack, capacidad de refrigeración, peso). Esto genera riesgo de sobrecargar racks o salas sin saberlo hasta que hay un problema real.
- Riesgo de continuidad ante incidencias físicas sin mapa virtual. Cuando un rack pierde alimentación, una PDU falla o se planifica un mantenimiento de UPS, el equipo de infraestructura no tiene forma rápida de saber qué VMs y qué servicios se verán afectados. Sin el cruce físico-virtual, la evaluación de impacto es manual, lenta e incompleta, lo que alarga los tiempos de respuesta y aumenta el riesgo de afectar servicios críticos sin previo aviso.
- Escalabilidad del despliegue sin perder el control. En entornos grandes (con con 13 vCenters en múltiples sedes y más de 4000 hipervisores), la creación de VMs crece exponencialmente. Sin un flujo automatizado que registre cada VM en el DCiM con su ubicación física, el inventario se desactualiza en semanas. El negocio pierde la foto real de qué tiene, dónde lo tiene y cuánto le cuesta mantenerlo.
- Capacidad real vs. capacidad teórica: El DCiM conoce la capacidad teórica de cada servidor físico (las specs de fábrica y datos nominales). Pero no sabe cuánto de eso se está usando realmente. El hypervisor sí lo sabe: sabe que ese servidor con 256 GB de RAM está usando 47 GB, que sus 32 cores están al 12%, y que aloja 14 VMs de las cuales 6 llevan semanas sin actividad. Sin ese dato en el DCiM, las decisiones de capacidad se toman con la cifra del catálogo, no con la cifra real. El resultado es infraestructura sobredimensionada que nadie se atreve a consolidar porque no hay visibilidad de uso real.
- Distribución de VMs: saber qué carga hay en cada punto físico. VMware gestiona la distribución de VMs entre hosts de forma transparente (vMotion, DRS), pero esa redistribución es invisible para quien gestiona la infraestructura física. Una VM crítica puede migrar de un host en la Sala A a otro en la Sala B sin que el equipo de infraestructura se entere. Esto tiene consecuencias directas: el peso térmico y eléctrico de un rack cambia sin que el DCiM lo refleje, la planificación de mantenimientos se hace sobre una foto desactualizada, y ante una incidencia en una sala concreta no se sabe qué carga virtual real está soportando en ese momento. Por ejemplo, detectar que un rack con 4 hosts concentra el 60% de las VMs críticas de producción; un dato que ni vCenter ni el DCiM pueden dar por separado.
- El primer reto fue de escala y unicidad de identificadores: había que integrar siete instancias de VMware contra una única instancia de iTRACS. Al consolidar los inventarios de los siete vCenter en un mismo destino, aparecieron colisiones que no existen cuando se trabaja con un único origen: las réplicas de backup arrastraban los mismos identificadores que sus máquinas de producción (entre ellos la IP, que iTRACS trata como valor único), de modo que una misma máquina podía llegar duplicada desde varios orígenes. Esto obligó a replantear la lógica de matcheo para poder distinguir el origen de cada registro y decidir cuál es la instancia buena antes de crear, actualizar o eliminar nada en iTRACS.
- El segundo reto no fue tecnológico, sino organizativo con impacto directo en el diseño de la integración: por política interna, el equipo de virtualización solo autorizaba una llamada a la API de VMware cada 24 horas. Eso elimina cualquier posibilidad de sincronización frecuente o de reintentos ante fallo: cada ejecución debe extraer todo lo necesario a la primera, ser tolerante a errores parciales y dejar constancia suficiente en los logs, porque el siguiente intento no llega hasta el día siguiente. Condicionó tanto la frecuencia del ETL como el diseño del proceso, que pasó a estar orientado a una única pasada completa en lugar de a sincronizaciones incrementales.
Los sistemas del ecosistema
SISTEMA | DESCRIPCIÓN | APORTA | RECIBE |
VMware (vCenter) | Plataforma de virtualización que gestiona la infraestructura virtual del cliente. | Inventario de hypervisores y máquinas virtuales, vía su API. | Nada: actúa como origen en un flujo unidireccional de solo lectura. |
iTRACS DCiM | Sistema de gestión de infraestructura del centro de datos, donde reside el inventario maestro. | Nada: es el destino de los datos. | Los objetos de infraestructura virtual ya mapeados, en lotes, para crear, actualizar o eliminar en cada servidor en el que se ejecutan. |
El diagrama de conexión
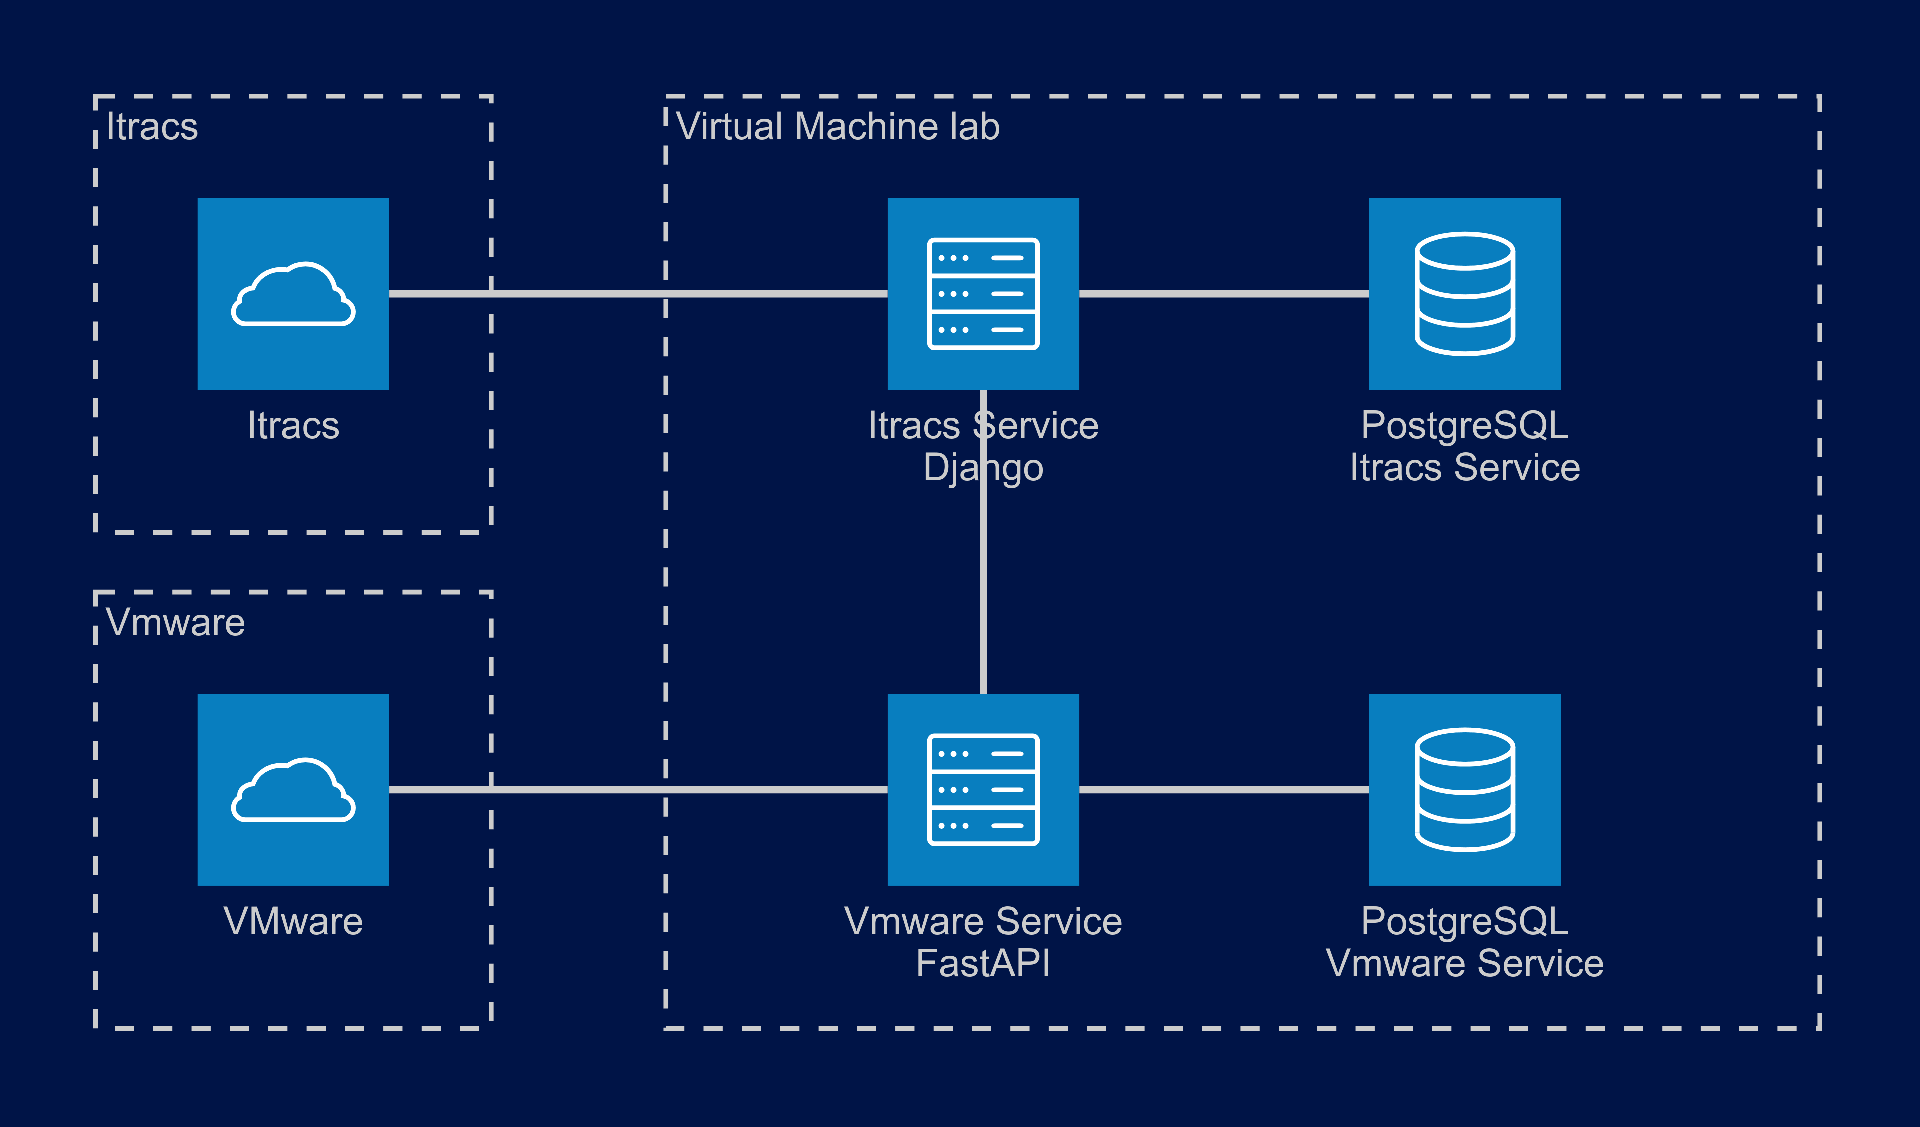
La integración se despliega sobre una única máquina virtual que aloja los dos servicios y sus respectivas bases de datos, dejando fuera de su perímetro los dos sistemas externos: VMware (vCenter) como origen e iTRACS como destino. VMware Service es el único componente que habla con la API de VMware: extrae hypervisoresy máquinas virtuales, los normaliza y los persiste en su base de datos. iTRACS Service recibe de él esa información ya mapeado y se encarga de escribir en iTRACS, apoyándose también en su propia base de datos para controlar duplicados y fallos.
Por qué esta arquitectura
El desdoble en dos servicios con base de datos independiente es la respuesta directa a la restricción de una sola llamada a VMware cada 24 horas. Al persistir localmente tanto el inventario extraído como los errores de cada carga, el proceso puede reintentar contra iTRACS tantas veces como haga falta, o corregir un mapeo y relanzar, sin volver a atacar la API de VMware. La base de datos actúa así como la fuente de verdad de la ventana diaria: separa el ciclo de extracción del ciclo de carga, permite reprocesar solo los registros fallidos en lugar de repetir la extracción completa, y deja trazabilidad de qué falló y por qué hasta la siguiente ventana disponible.
El flujo de datos en acción
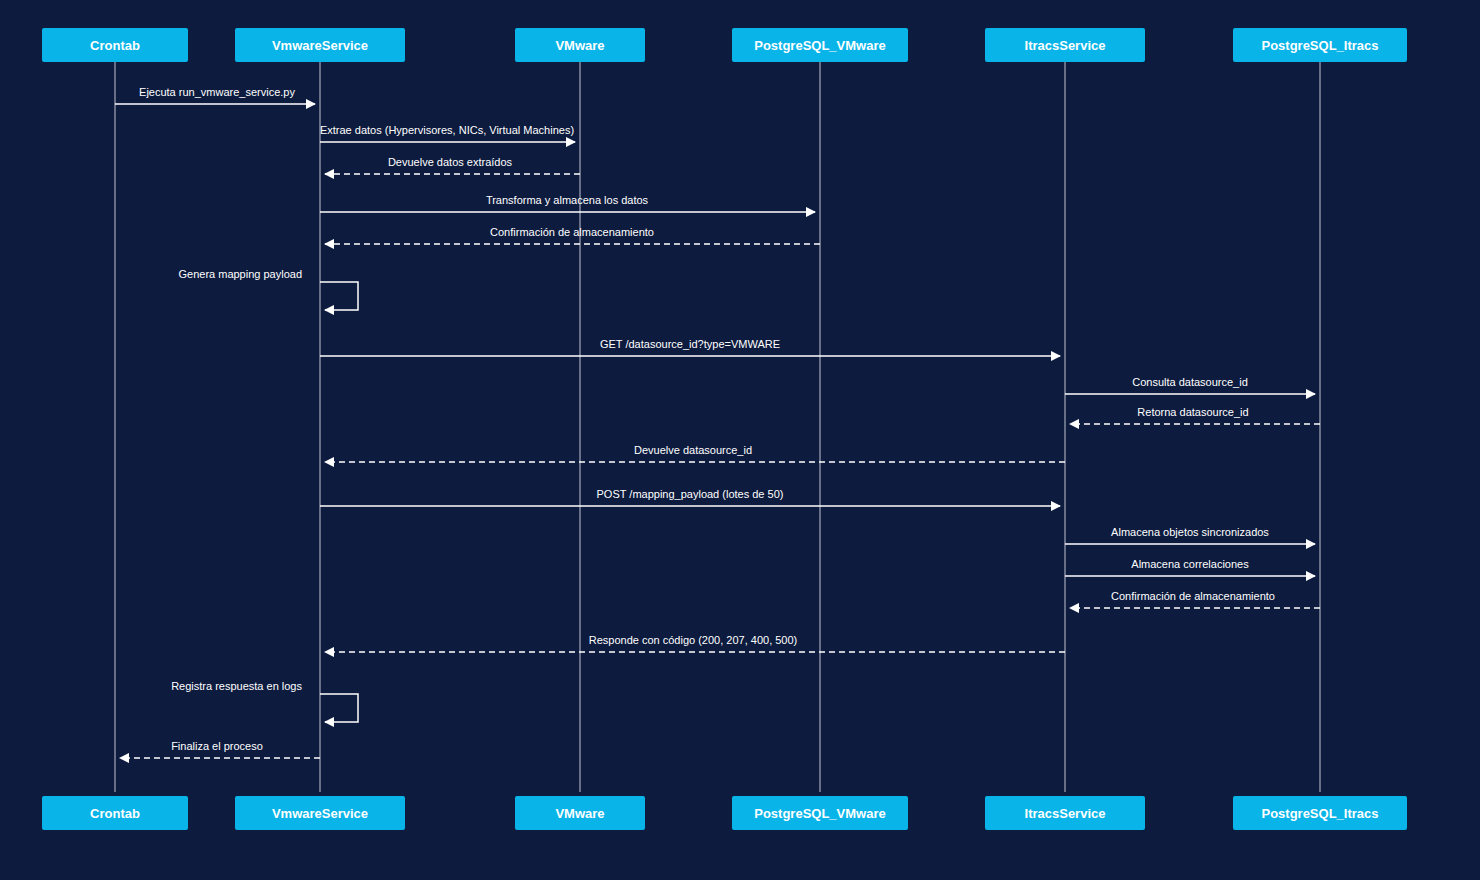
Flujo de sincronización de inventario virtual: de VMware a iTRACS
Arranque en la ventana autorizada
El crontab lanza el proceso dentro de la ventana diaria autorizada por el equipo de virtualización.
VMwareService solicita a VMware el inventario de hypervisores y máquinas virtuales, y recibe los datos extraídos.
Normalización y persistencia
VMwareService transforma esa información y la almacena en su base de datos, que queda como fuente de verdad local hasta la siguiente ventana.
Reconciliación de altas, cambios y bajas
Se reconcilia lo extraído contra lo ya almacenado para determinar altas, modificaciones y bajas, resolviendo las colisiones de identificadores entre las siete instancias de origen.
VMwareService genera el payload de mapeo, traduciendo los atributos de VMware a la estructura que espera iTRACS.
Identificador del origen de datos
VMwareService pide a ItracsService el identificador del origen de datos, que este consulta en su propia base de datos y devuelve.
VMwareService envía el payload por lotes a ItracsService.
iTRACSService almacena los objetos sincronizados y sus correlaciones, y confirma el resultado a VMwareService.
Registro y cierre
VMwareService registra la respuesta, lo que permite reintentar la carga sin volver a atacar la API de VMware, y devuelve el control al crontab.
VOLUMEN
7 instancias de vCenter consolidadas contra una única instancia de iTRACS, con envío al destino en batches de 1000 registros máximo.
FRECUENCIA
Una ejecución completa cada 24 horas, limitada por política del equipo de virtualización.
Lo que hizo la diferencia
Decisiones de diseño que no eran las obvias, y por qué las tomamos.
Clave 2: modularización
Previmos que la fuente de los datos iba a estar distribuida en distintos vCenters, por lo que preparamos un servicio que centralizara esos datos. Esto, además, nos permitió mitigar los problemas que daba el hacer una sola extracción. Movemos la fuente de la verdad de la integración al VMwareService, de manera que podemos matchear los datos sin atacar la API de VMware.
Impacto: Machear los datos sin atacar la API en VMware
Clave 1: todos los parámetros son configurables
Preparamos la integración de manera que fuera configurable en frecuencias de hasta 1 minuto. Este cliente puso el límite de una vez a las 24 horas, pero nuestra integración permite configurarse dependiendo de las necesidades del data center.
Impacto: Configurable en frecuencias de hasta 1 minuto
Es fundamental conocer la relación entre la infraestructura lógica y la física para una correcta operativa del datacenter.
Cuéntanos qué sistemas tienes y qué necesitas que se hablen.