O inventário virtual do VMware levado até ao rack: sete vCenter num único iTRACS
Mais de 50 variáveis de cada VM e de cada hipervisor, desde a utilização de CPU até à VLAN, colocadas no rack exato onde se encontra o servidor físico.
O QUE ESTAMOS A INTEGRAR
Relações entre hipervisores e máquinas virtuais e os servidores em que são executados. No nosso caso de sucesso, estamos a integrar os dados de 7 instâncias de VMware, algumas com milhares de máquinas virtuais, num único DCiM.
SISTEMAS INTEGRADOS
VMWare + ITRACs
RESULTADO PRINCIPAL
Saber que serviços são executados em que máquinas, para prevenir falhas ou erros causados pela existência de dois silos de conhecimento separados (infraestrutura física e virtualização).
Contexto da integração
iTRACS ON PREM
API utilizada pela integração:
- iTRACS API REST V24.3
Implementação:
- Python 3.10
- Django 5.0 + Django REST Framework
- PostgreSQL 13 nativos en la MV
- Serviço com Gunicorn + Nginx
VMware ON PREM
API utilizada pela integração:
- vSphere Web Services API 8.0 U3
Implementado em contentores Docker, um contentor por vCenter (atualmente 13)
- Python 3.10
- FastAPI 0.112.0
- PostgreSQL 13
- Serviço com Uvicorn (servidor ASGI)
O desafio: porque era necessária esta integração?
- Desconexão total entre o inventário virtual e o inventário físico. A equipa de virtualização gere centenas ou milhares de VMs no vCenter, enquanto a equipa de infraestrutura gere os ativos físicos no DCiM. Quando alguém pergunta “em que rack está o servidor que executa esta VM crítica?”, a resposta exige cruzar manualmente dois sistemas que não comunicam entre si. Isto torna-se um estrangulamento operacional em cada incidente, em cada auditoria e em cada alteração planeada.
- Impossibilidade de detetar servidores zombie e otimizar a capacidade. Sem integração, não existe forma automatizada de cruzar o consumo real de recursos das VMs (CPU, memória, disco) com a localização física e a capacidade disponível do rack. As VMs abandonadas (“zombies”) continuam a consumir energia, licenças e espaço sem que ninguém o detete. O dado de utilização está no vCenter e o dado de custo físico está no DCiM.
- Planeamento de capacidade às cegas. Quando é preciso implementar novas VMs ou consolidar hipervisores, a decisão sobre “onde colocar a carga” é tomada sem visibilidade sobre o impacto na infraestrutura física (energia disponível no rack, capacidade de refrigeração, peso). Isto gera o risco de sobrecarregar racks ou salas sem o saber até surgir um problema real.
- Risco para a continuidade perante incidentes físicos sem mapa virtual. Quando um rack perde alimentação, uma PDU falha ou se planeia uma manutenção de UPS, a equipa de infraestrutura não tem forma rápida de saber que VMs e que serviços serão afetados. Sem o cruzamento físico-virtual, a avaliação de impacto é manual, lenta e incompleta. Isto aumenta os tempos de resposta e o risco de afetar serviços críticos sem aviso prévio.
- Escalar a implementação sem perder o controlo. Em ambientes de grande dimensão (com 13 vCenter em vários locais e mais de 4000 hipervisores), a criação de VMs cresce exponencialmente. Sem um fluxo automatizado que registe cada VM no DCiM com a sua localização física, o inventário fica desatualizado em semanas. O negócio perde a imagem real do que tem, onde o tem e quanto lhe custa mantê-lo.
- Capacidade real vs. capacidade teórica. O DCiM conhece a capacidade teórica de cada servidor físico (especificações de fábrica e dados nominais). Mas não sabe quanto dessa capacidade está realmente a ser utilizada. O hipervisor sabe. Sabe que esse servidor com 256 GB de RAM está a usar 47 GB, que os seus 32 cores estão a 12% e que aloja 14 VMs, das quais 6 estão sem atividade há semanas. Sem esse dado no DCIM, as decisões de capacidade são tomadas com o valor do catálogo, não com o valor real. O resultado é uma infraestrutura sobredimensionada que ninguém se atreve a consolidar, por falta de visibilidade sobre a utilização real.
- Distribuição de VMs: saber que carga existe em cada ponto físico. O VMware gere a distribuição de VMs entre hosts de forma transparente (vMotion, DRS), mas essa redistribuição é invisível para quem gere a infraestrutura física. Uma VM crítica pode migrar de um host na Sala A para outro na Sala B sem que a equipa de infraestrutura tenha conhecimento. Isto tem consequências diretas. A carga térmica e elétrica de um rack muda sem que o DCIM o reflita. A manutenção é planeada sobre uma imagem desatualizada. E, perante um incidente numa sala concreta, não se sabe que carga virtual real essa sala está a suportar nesse momento. Por exemplo: detetar que um rack com 4 hosts concentra 60% das VMs críticas de produção, um dado que nem o vCenter nem o DCiM conseguem fornecer isoladamente.
- O primeiro desafio foi de escala e de unicidade dos identificadores: era necessário integrar sete instâncias de VMware numa única instância de iTRACS. Ao consolidar os inventários dos sete vCenter num mesmo destino, surgiram colisões que não existem quando se trabalha com uma única origem. As réplicas de backup transportavam os mesmos identificadores que as respetivas máquinas de produção, entre eles o IP, que o iTRACS trata como valor único. Assim, uma mesma máquina podia chegar duplicada a partir de várias origens. Isto obrigou a repensar a lógica de correspondência, para distinguir a origem de cada registo e decidir qual é a instância correta antes de criar, atualizar ou eliminar o que quer que seja no iTRACS.
- O segundo desafio não foi tecnológico, mas organizacional, com impacto direto no design da integração. Por política interna, a equipa de virtualização só autorizava uma chamada à API do VMware a cada 24 horas. Isso elimina qualquer possibilidade de sincronização frequente ou de novas tentativas em caso de falha. Cada execução tem de extrair tudo o que é necessário à primeira, tolerar erros parciais e deixar registo suficiente nos logs, porque a tentativa seguinte só acontece no dia seguinte. Isto condicionou tanto a frequência do ETL como o design do processo, que passou a estar orientado para uma única passagem completa em vez de sincronizações incrementais.
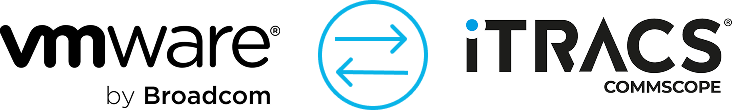
Os sistemas do ecossistema
SISTEMA | DESCRIÇÃO | FORNECE | RECEBE |
VMware (vCenter) | Plataforma de virtualização que gere a infraestrutura virtual do cliente. | Inventário de hipervisores e máquinas virtuais, através da sua API. | Nada: atua como origem num fluxo unidirecional apenas de leitura. |
iTRACS DCiM | Sistema de gestão de infraestrutura do centro de dados, onde reside o inventário mestre. | Nada: é o destino dos dados. | Os objetos de infraestrutura virtual já mapeados, em lotes, para criar, atualizar ou eliminar em cada servidor em que são executados. |
O diagrama de ligação
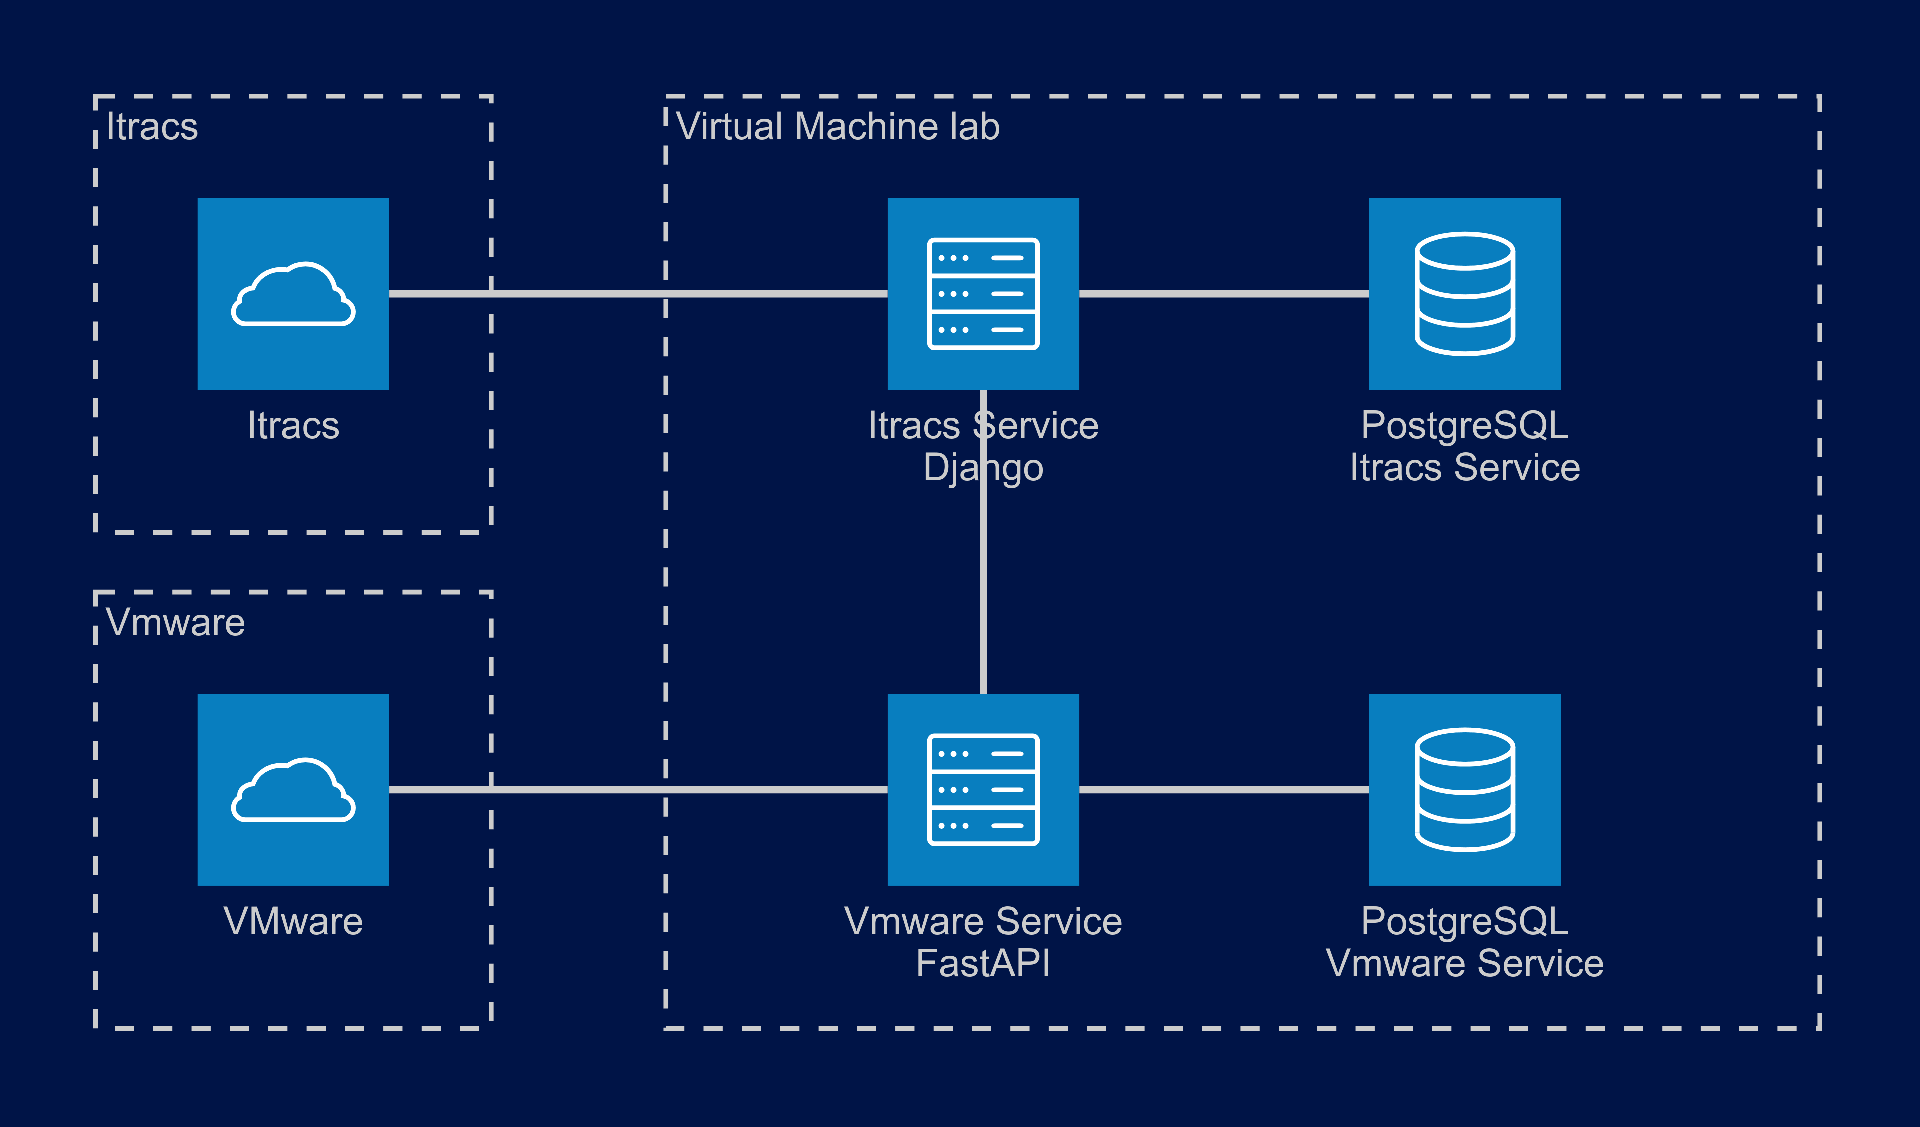
A integração é implementada numa única máquina virtual que aloja os dois serviços e as respetivas bases de dados. Os dois sistemas externos ficam fora do seu perímetro: o VMware (vCenter) como origem e o iTRACS como destino. O VMware Service é o único componente que comunica com a API do VMware: extrai hipervisores e máquinas virtuais, normaliza-os e guarda-os na sua base de dados. O iTRACS Service recebe dele essa informação já mapeada e encarrega-se de a escrever no iTRACS, apoiando-se também na sua própria base de dados para controlar duplicados e falhas.
Porquê esta arquitetura
A divisão em dois serviços com bases de dados independentes é a resposta direta à restrição de uma única chamada ao VMware a cada 24 horas. Ao guardar localmente tanto o inventário extraído como os erros de cada carga, o processo pode voltar a tentar no iTRACS tantas vezes quantas forem necessárias, ou corrigir um mapeamento e relançar, sem voltar a chamar a API do VMware. A base de dados atua, assim, como a fonte de verdade da janela diária. Separa o ciclo de extração do ciclo de carga, permite reprocessar apenas os registos com falha em vez de repetir a extração completa e mantém a rastreabilidade do que falhou e porquê até à janela seguinte disponível.
O fluxo de dados em ação
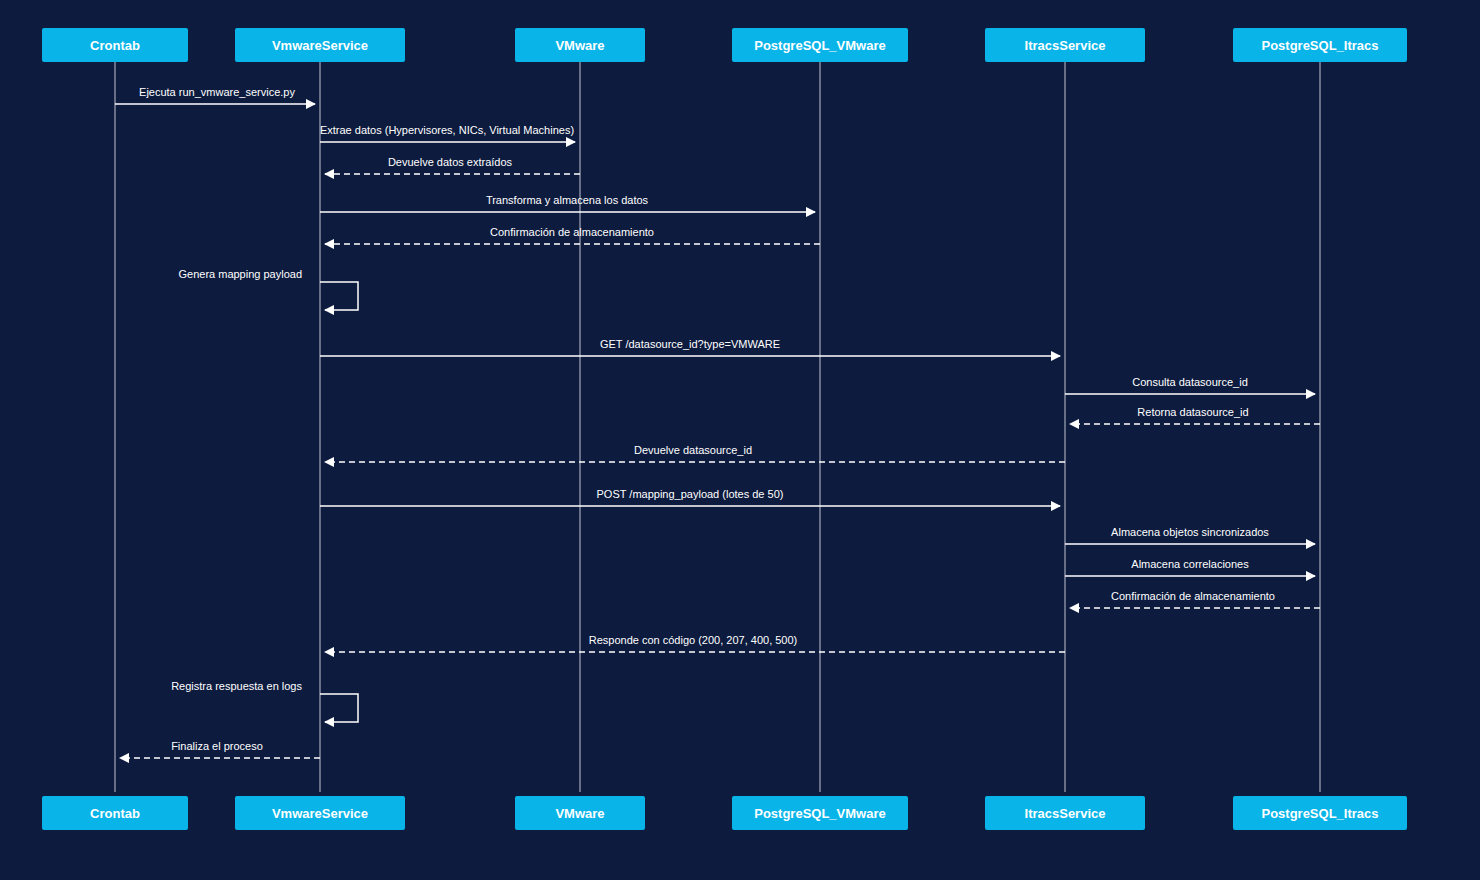
Fluxo de sincronização do inventário virtual: do VMware para o iTRACS
Arranque na janela autorizada
O crontab lança o processo dentro da janela diária autorizada pela equipa de virtualização.
O VMwareService solicita ao VMware o inventário de hipervisores e máquinas virtuais e recebe os dados extraídos.
Normalização e persistência
O VMwareService transforma essa informação e guarda-a na sua base de dados, que fica como fonte de verdade local até à janela seguinte.
Reconciliação de criações, alterações e eliminaçõe
Os dados extraídos são reconciliados com os já armazenados para determinar criações, alterações e eliminações, resolvendo as colisões de identificadores entre as sete instâncias de origem.
O VMwareService gera o payload de mapeamento, traduzindo os atributos do VMware para a estrutura que o iTRACS espera.
Identificador da origem de dados
O VMwareService pede ao iTRACSService o identificador da origem de dados, que este consulta na sua própria base de dados e devolve.
O VMwareService envia o payload por lotes para o iTRACSService.
O iTRACSService guarda os objetos sincronizados e as respetivas correlações, e confirma o resultado ao VMwareService.
Registo e fecho
O VMwareService regista a resposta, o que permite voltar a tentar a carga sem voltar a chamar a API do VMware, e devolve o controlo ao crontab.
VOLUME
7 instâncias de vCenter consolidadas numa única instância de iTRACS, com envio para o destino em lotes de 1000 registos no máximo.
FREQUÊNCIA
Uma execução completa a cada 24 horas, limitada pela política da equipa de virtualização.
O que fez a diferença
Decisões de design que não eram as óbvias, e por que razão as tomámos.
Chave 2: modularização
Previmos que a fonte dos dados ia estar distribuída por vários vCenter, por isso preparámos um serviço que centralizasse esses dados. Isto permitiu-nos, além disso, mitigar os problemas causados por existir uma única extração. Passámos a fonte de verdade da integração para o VMwareService, de forma a podermos fazer a correspondência dos dados sem chamar a API do VMware.
Impacto: Correspondência de dados sem chamar a API do VMware
Chave 1: todos os parâmetros são configuráveis
Preparámos a integração para ser configurável com frequências de até 1 minuto. Este cliente definiu o limite de uma vez a cada 24 horas, mas a nossa integração pode ser configurada de acordo com as necessidades de cada centro de dados.
Impacto: Configurável com frequências de até 1 minuto
Conhecer a relação entre a infraestrutura lógica e a física é fundamental para uma operação correta do centro de dados.
Diga-nos que sistemas tem e quais precisa que comuniquem entre si.