HPE IMC + iTRACS
O seu gestor de rede sabe que um switch está em baixo. O seu DCiM sabe em que rack está. Só quando os dois comunicam é que sabe a quem ligar e para onde ir.
O QUE ESTAMOS A INTEGRAR
Dados de ativos de rede (routers, switches e equipamentos de segurança) e monitorização do seu desempenho: CPU, memória, consumo elétrico, temperaturas, tráfego e estado das portas, associados ao ativo físico que já existe no DCiM.
SISTEMAS INTEGRADOS
HPE IMC + iTRACS
RESULTADO PRINCIPAL
Saber onde está fisicamente cada equipamento de rede e como se está a comportar. Assim, passa-se de um alarme numa consola lógica a uma intervenção no rack certo, e a rede ativa entra na equação energética do data center.
Contexto da integração
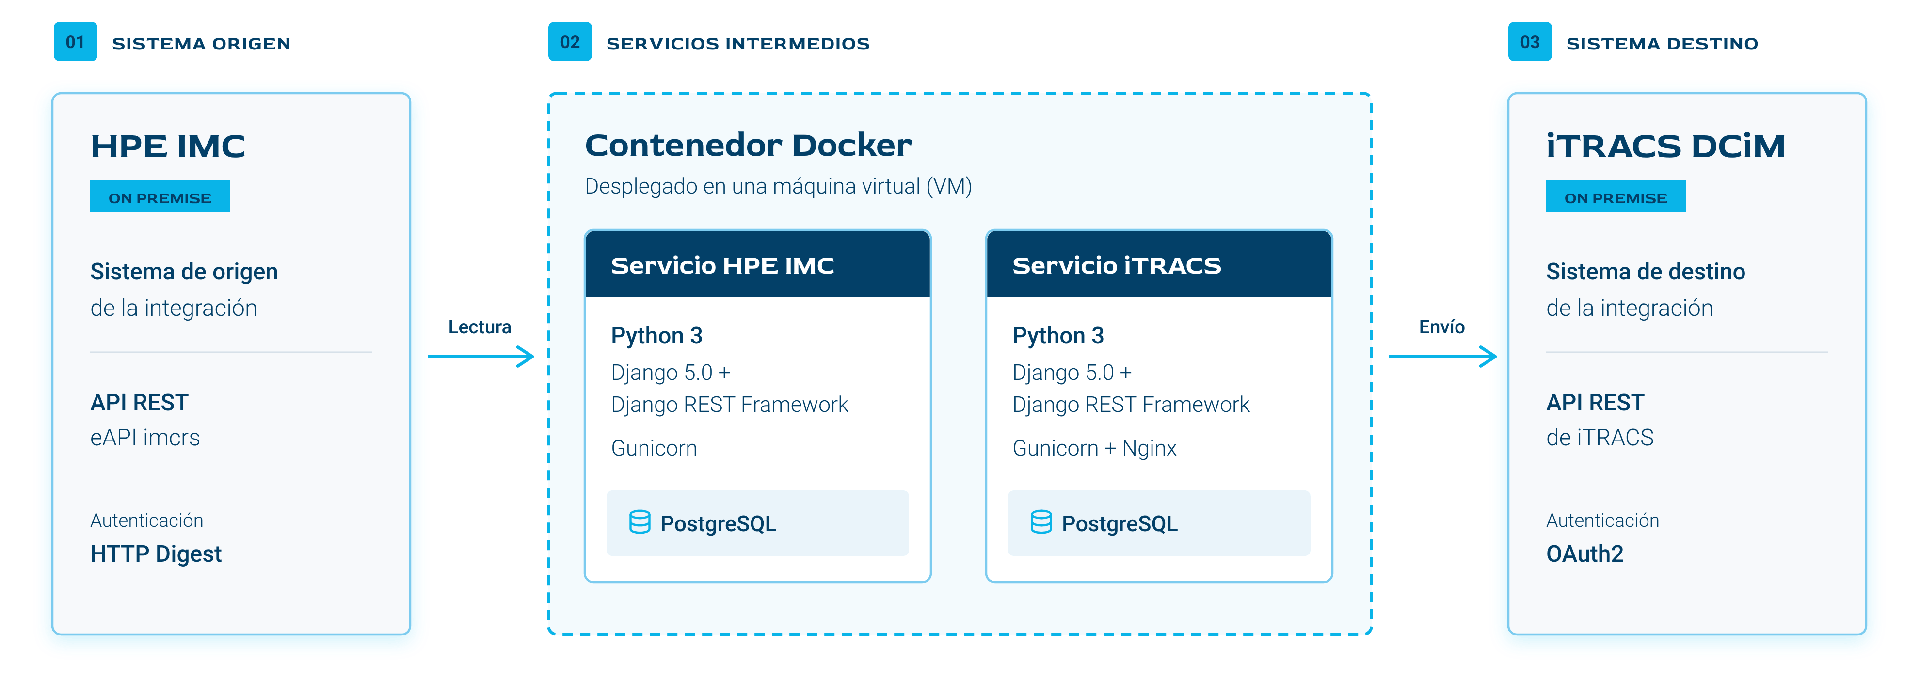
Ambiente: VM com os dois serviços de integração e as respetivas bases de dados (implementação em contentores com Docker).
O desafio: porque era necessária esta integração?
- Tempo de resolução de incidentes de rede multiplicado pela desconexão entre o físico e o lógico. Quando o HPE IMC deteta que um switch tem erros de tráfego, descartes elevados ou deixa de responder, a equipa de redes vê um alarme numa consola lógica: um nome, um IP, um ponto num mapa de topologia. Mas, para atuar fisicamente — ir ao equipamento, verificar os LEDs, voltar a ligar um cabo, substituir um módulo —, precisa de saber em que sala, em que fila, em que rack e em que unidade está montado. Sem integração, essa tradução do “lógico para o físico” é um processo manual. Pode consumir minutos valiosos num incidente crítico e depende de alguém ter uma folha de cálculo atualizada ou conhecer a sala de cor.
- Planeamento de capacidade de rede sem contexto da infraestrutura física. O HPE IMC sabe quanto tráfego passa por cada switch (média e pico de RX/TX), quantas portas estão ativas face ao total, e quanta CPU/memória consome cada equipamento. Mas esses dados vivem isolados do contexto físico: há espaço nesse rack para mais um switch? A PDU que o alimenta suporta mais carga? Sem cruzar o desempenho da rede com a capacidade física, as decisões de crescimento da rede são tomadas às cegas em relação à infraestrutura que a suporta.
- Consumo elétrico e térmico da rede invisível para a gestão da infraestrutura. Os switches e routers consomem energia e geram calor, mas tradicionalmente são tratados como “caixas negras” no cálculo energético do data center. O HPE IMC dispõe de dados reais de consumo (watts) e de temperatura (inlet, outlet, chassis, hotspot) de cada equipamento de rede. Sem integração, esses dados não chegam ao DCiM. Integrar esta informação permite, pela primeira vez, incluir a rede ativa na equação energética do data center.
- Deteção proativa de equipamentos de rede em risco através da correlação de métricas. O HPE IMC pode mostrar que um switch tem a CPU a 85% e erros de tráfego crescentes. O DCiM pode mostrar que esse switch está num rack onde a temperatura ambiente subiu 3 graus na última semana. Separadamente, nenhum dos dois dados dispara um alarme crítico. Juntos, revelam um equipamento em risco iminente de falha. Esta correlação cruzada entre desempenho lógico (IMC) e condições físicas (DCiM) só é possível com a integração. Permite passar de uma monitorização reativa para uma verdadeira gestão preventiva.
- O primeiro desafio foi o volume e a granularidade da API do HPE IMC. A API devolve o inventário de dispositivos de forma paginada, mas o número de série, o tipo de equipamento, a versão de firmware, as placas, as interfaces e as métricas de desempenho têm de ser pedidos separadamente, equipamento a equipamento. Numa rede de alguma dimensão, uma única execução implica milhares de chamadas. Isto obrigou a paralelizar as consultas, a incorporar novas tentativas automáticas perante quebras de ligação e a permitir desativar as partes mais exigentes do processo (como a contagem de portas por interface) quando não são necessárias em cada ciclo.
- O segundo desafio foi transformar o dado em bruto num dado útil para o DCiM. O HPE IMC expõe sensores muito heterogéneos: um mesmo switch pode reportar várias sondas de temperatura com nomes diferentes (inlet, outlet, chassis, fan, hotspot…), e o tráfego chega como média e pico de RX, TX, erros e descartes. O iTRACS, por sua vez, precisa de um valor representativo por equipamento. Foi necessário classificar cada sensor por tipo a partir da sua descrição e calcular métricas agregadas (por exemplo, temperatura média de entrada e de saída) antes de as enviar para o DCiM.
- O terceiro desafio foi a correspondência sem um identificador comum. O HPE IMC e o iTRACS não partilham nenhum ID. A correspondência entre o equipamento lógico e o ativo físico é resolvida por nome, número de série e IP. Uma vez encontrada, é guardada como correlação para que as execuções seguintes vão diretamente ao objeto certo. Além disso, o HPE IMC gere todo o tipo de dispositivos (impressoras, postos de trabalho, câmaras, telefonia…), pelo que a integração filtra e trabalha apenas com routers, switches e equipamentos de segurança.
Os sistemas do ecossistema
SISTEMA | DESCRIÇÃO | FORNECE | RECEBE |
HPE IMC (Intelligent Management Center) | Plataforma de gestão de rede da HPE que monitoriza os equipamentos de rede do cliente: inventário, topologia e desempenho. | Inventário de equipamentos de rede (nome, IP, número de série, modelo, firmware, MAC), placas, portas totais e ativas, e métricas de desempenho (CPU, memória, consumo, temperatura, tráfego), através da sua API. | Nada: atua como origem num fluxo unidirecional apenas de leitura. |
iTRACS DCIM | Sistema de gestão de infraestrutura do centro de dados, onde reside o inventário mestre. | Nada: é o destino dos dados. | Os equipamentos de rede já localizados no seu rack, enriquecidos com os seus atributos e métricas de desempenho, em lotes, para os criar ou atualizar. |
O diagrama de ligação
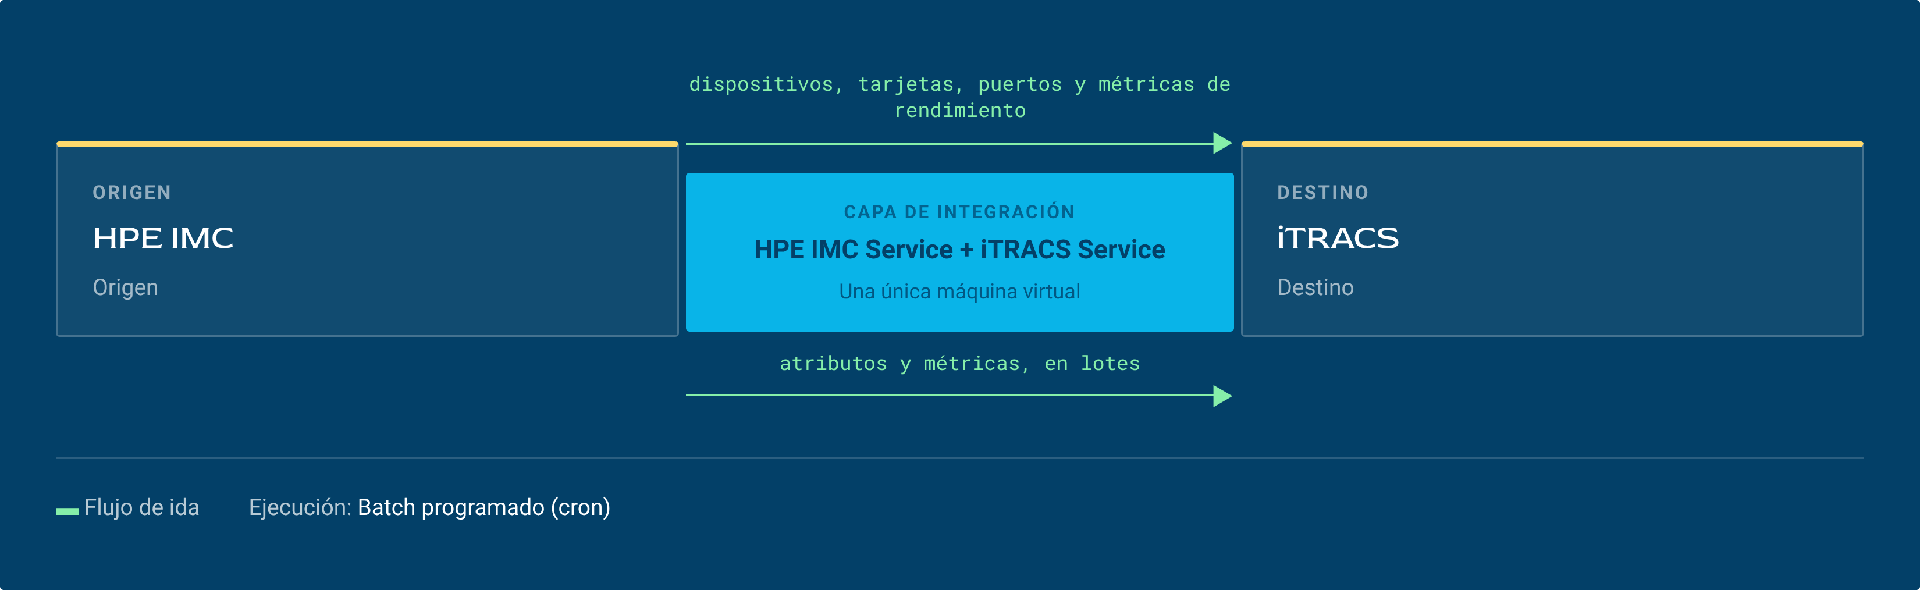
A integração é implementada numa única máquina virtual que aloja os dois serviços e as respetivas bases de dados. Os dois sistemas externos ficam fora do seu perímetro: o HPE IMC como origem e o iTRACS como destino. O HPE IMC Service é o único componente que comunica com a API do HPE IMC: extrai dispositivos, placas, portas e métricas de desempenho, normaliza-os e guarda-os na sua base de dados. O iTRACS Service recebe essa informação já mapeada e encarrega-se de a escrever no iTRACS, apoiando-se na sua própria base de dados para correlacionar objetos, controlar duplicados e repetir tentativas falhadas.
Porquê esta arquitetura
É a mesma arquitetura de dois serviços que utilizamos nas restantes integrações com o iTRACS (como a do VMware). Isto permite reutilizar o serviço de carga e acrescentar novas origens sem mexer no lado do DCiM. Cada objeto é guardado com uma impressão digital (hash) do seu conteúdo, de modo que, em cada execução, só segue para o iTRACS o que realmente mudou. O serviço de origem está, além disso, preparado para enviar dados para mais do que um destino, pelo que o mesmo fluxo poderá alimentar outros DCiM no futuro.
O fluxo de dados em ação
Fluxo de sincronização de equipamentos de rede e respetivas métricas: do HPE IMC para o iTRACS
O crontab lança o ETL do HPE IMC Service. Um bloqueio de execução impede que dois ciclos se sobreponham se um deles se prolongar.
Para cada equipamento, consulta em paralelo o número de série, o tipo e a versão de firmware, conta as portas Ethernet totais e obtém as suas placas.
Recupera as métricas de desempenho de cada equipamento (CPU, memória, consumo elétrico, temperatura, tráfego RX/TX, erros e descartes), classifica cada sensor por tipo e calcula as métricas agregadas por equipamento (por exemplo, temperatura média de entrada e de saída).
O HPE IMC Service pede ao iTRACS Service o identificador da origem de dados HPE IMC e envia-lhe, por lotes, apenas os ativos e as métricas que mudaram.
VOLUME
Em cada ciclo, só seguem para o iTRACS os objetos que mudaram, em lotes de tamanho configurável.
FREQUÊNCIA
Execução batch programada, com frequência configurável de acordo com as necessidades do data center.
O que fez a diferença
Decisões de design que não eram as óbvias, e porque as tomámos.
Fator-chave 2: Do sensor à métrica
Em vez de despejar no DCiM centenas de sondas em bruto, a integração interpreta os sensores do HPE IMC, classifica-os por tipo e consolida-os num conjunto reduzido de métricas por equipamento que um DCIM sabe utilizar: % de CPU, % de RAM, consumo em W e temperatura de entrada e de saída. O dado chega pronto para a análise de capacidade e para incluir a rede ativa no balanço energético e térmico do data center.
Fator-chave 1: Sincronização por diferenças
Cada equipamento, sensor e métrica é guardado com uma impressão digital (hash) do seu conteúdo. Em cada ciclo, compara-se o que chega do HPE IMC com o que está armazenado e só se envia para o iTRACS o que mudou. Os equipamentos que desaparecem da rede são marcados como inativos em vez de serem apagados. Isto reduz drasticamente o número de escritas no DCiM e permite aumentar a frequência de sincronização sem penalizar o seu desempenho. Além disso, a execução é configurável: é possível sincronizar todo o inventário ou apenas os tipos de equipamento relevantes, dispensar a contagem de portas nos ciclos rápidos ou lançar uma execução de teste (dry run) que não escreve no destino.
Vamos falar da sua integração?
Diga-nos que sistemas tem e quais precisa que comuniquem entre si.