HPE IMC + iTRACS
Tu gestor de red sabe que un switch está caído. Tu DCiM sabe en qué rack está. Solo cuando los dos se hablan sabes a quién llamar y a dónde ir.
QUÉ ESTAMOS INTEGRANDO
Datos de activos de red (routers, switches y equipos de seguridad) y monitoreo de su rendimiento: CPU, memoria, consumo eléctrico, temperaturas, tráfico y estado de puertos, aterrizados sobre el activo físico que ya existe en el DCiM.
SISTEMAS INTEGRADOS
HPE IMC + iTRACS
RESULTADO PRINCIPAL
Saber dónde está físicamente cada equipo de red y cómo se está comportando, para pasar de una alarma en una consola lógica a una intervención en el rack correcto, e incluir la red activa en la ecuación energética del data center.
Contexto de la integración
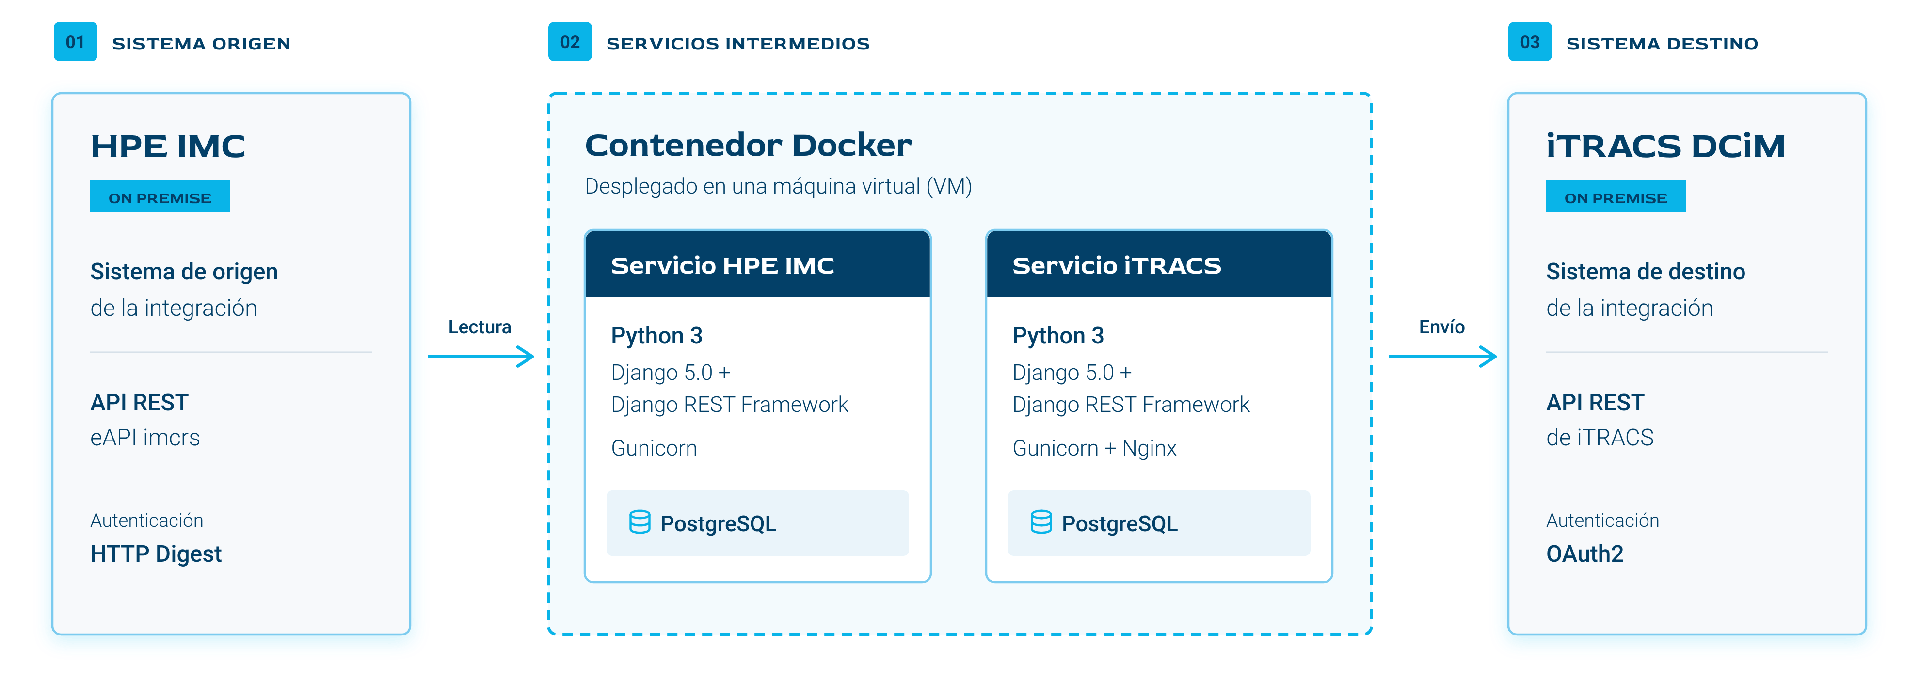
Entorno: VM con los dos servicios de integración y sus bases de datos (despliegue contenerizado con Docker).
El reto: ¿por qué era necesaria esta integración?
- Tiempo de resolución de incidencias de red multiplicado por la desconexión físico-lógica. Cuando HP IMC detecta que un switch tiene errores de tráfico, descartes elevados o deja de responder, el equipo de redes ve una alarma en una consola lógica: un nombre, una IP, un punto en un mapa de topología. Pero para actuar físicamente, ir al equipo, verificar LEDs, reconectar un cable, sustituir un módulo, necesitan saber en qué sala, en qué fila, en qué rack y en qué unidad está montado. Sin integración, esa traducción de "lógico a físico" es un proceso manual que puede consumir minutos valiosos en una incidencia crítica, y que depende de que alguien tenga actualizada una hoja de cálculo o conozca la sala de memoria.
- Planificación de capacidad de red sin contexto de infraestructura física. HPE IMC sabe cuánto tráfico pasa por cada switch (media y pico de RX/TX), cuántos puertos están levantados vs. totales, y cuánta CPU/memoria consume cada equipo. Pero esos datos viven aislados del contexto físico: ¿hay espacio en ese rack para añadir otro switch?, ¿la PDU que lo alimenta soporta más carga? Sin cruzar rendimiento de red con capacidad física, las decisiones de crecimiento de la red se toman a ciegas respecto a la infraestructura que la soporta.
- Consumo eléctrico y térmico de la red invisible para la gestión de infraestructura. Los switches y routers consumen energía y generan calor, pero tradicionalmente se tratan como "cajas negras" en el cálculo energético del data center. HPE IMC dispone de datos reales de consumo (vatios) y temperaturas (inlet, outlet, chassis, hotspot) de cada equipo de red. Sin integración, esos datos no llegan. Integrar esta información permite por primera vez incluir la red activa en la ecuación energética del data center.
- Detección proactiva de equipos de red en riesgo por correlación de métricas. HPE IMC puede mostrar que un switch tiene la CPU al 85% y errores de tráfico crecientes. El DCiM puede mostrar que ese switch está en un rack donde la temperatura ambiente ha subido 3 grados en la última semana. Por separado, ninguno de los dos datos dispara una alarma crítica. Juntos, dibujan un equipo en riesgo inminente de fallo. Esta correlación cruzada entre rendimiento lógico (IMC) y condiciones físicas (DCiM) solo es posible con la integración, y permite pasar de una monitorización reactiva a una gestión preventiva real.
- El primer reto fue el volumen y la granularidad de la API de HPE IMC. La API devuelve el inventario de dispositivos de forma paginada, pero el número de serie, el tipo de equipo, la versión de firmware, las tarjetas, las interfaces y las métricas de rendimiento hay que pedirlos por separado, equipo a equipo. En una red de cierto tamaño, una sola ejecución supone miles de llamadas. Esto obligó a paralelizar las consultas, a incorporar reintentos automáticos ante cortes de conexión y a permitir desactivar las partes más costosas del proceso (como el conteo de puertos por interfaz) cuando no son necesarias en cada ciclo.
- El segundo reto fue convertir el dato bruto en un dato útil para el DCiM. HPE IMC expone sensores muy heterogéneos: un mismo switch puede reportar varias sondas de temperatura con nombres distintos (inlet, outlet, chassis, fan, hotspot…), y el tráfico llega como media y pico de RX, TX, errores y descartes. iTRACS, en cambio, necesita un valor representativo por equipo. Hubo que clasificar cada sensor por tipo a partir de su descripción y calcular métricas agregadas (por ejemplo, temperatura media de entrada y de salida) antes de enviarlas al DCiM.
- El tercer reto fue el emparejamiento sin un identificador común. HPE IMC y iTRACS no comparten ningún ID. La correspondencia entre el equipo lógico y el activo físico se resuelve por nombre, número de serie e IP, y una vez encontrada se guarda como correlación para que las siguientes ejecuciones vayan directas al objeto correcto. Además, HPE IMC gestiona todo tipo de dispositivos (impresoras, puestos de trabajo, cámaras, telefonía…), por lo que la integración filtra y solo trabaja con routers, switches y equipos de seguridad.
Los sistemas del ecosistema
SISTEMA | DESCRIPCIÓN | APORTA | RECIBE |
HPE IMC (Intelligent Management Center) | Plataforma de gestión de red de HPE que monitoriza los equipos de red del cliente: inventario, topología y rendimiento. | Inventario de equipos de red (nombre, IP, número de serie, modelo, firmware, MAC), tarjetas, puertos totales y activos, y métricas de rendimiento (CPU, memoria, consumo, temperatura, tráfico), vía su API. | Nada: actúa como origen en un flujo unidireccional de solo lectura. |
iTRACS DCiM | Sistema de gestión de infraestructura del centro de datos, donde reside el inventario maestro. | Nada: es el destino de los datos. | Los equipos de red ya ubicados en su rack, enriquecidos con sus atributos y métricas de rendimiento, en lotes, para crearlos o actualizarlos. |
El diagrama de conexión
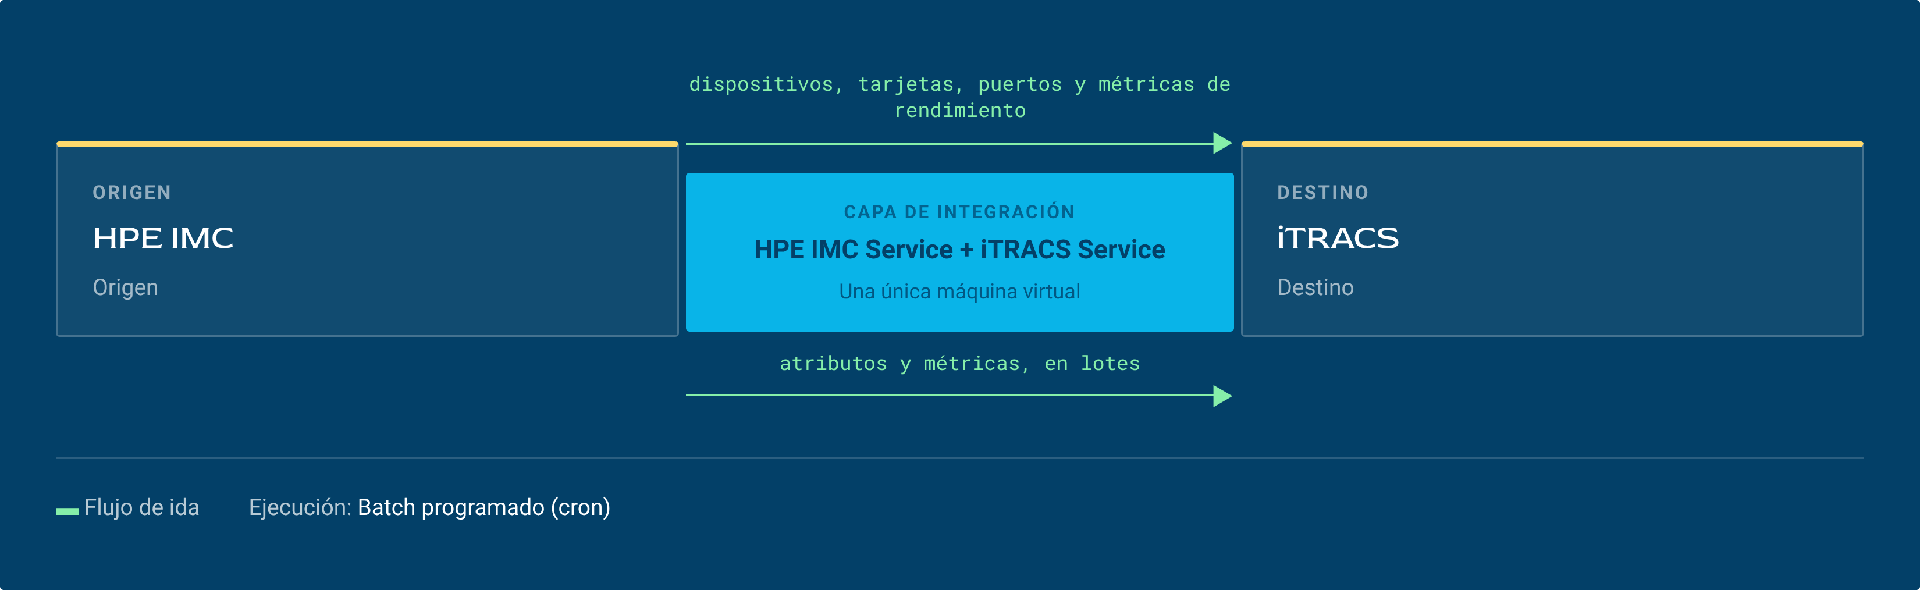
La integración se despliega sobre una única máquina virtual que aloja los dos servicios y sus respectivas bases de datos, dejando fuera de su perímetro los dos sistemas externos: HPE IMC como origen e iTRACS como destino. HPE IMC Service es el único componente que habla con la API de HPE IMC: extrae dispositivos, tarjetas, puertos y métricas de rendimiento, los normaliza y los persiste en su base de datos. iTRACS Service recibe de él esa información ya mapeada y se encarga de escribir en iTRACS, apoyándose en su propia base de datos para correlacionar objetos, controlar duplicados y reintentar fallos.
Por qué esta arquitectura
Es la misma arquitectura de dos servicios que utilizamos en el resto de integraciones con iTRACS (como la de VMware), lo que permite reutilizar el servicio de carga y desplegar nuevos orígenes sin tocar el lado del DCiM. Cada objeto se guarda con una huella (hash) de su contenido, de modo que en cada ejecución solo viaja a iTRACS lo que realmente ha cambiado. El servicio de origen está además preparado para enviar a más de un destino, por lo que el mismo flujo puede alimentar otros DCiIM en el futuro.
El flujo de datos en acción
Flujo de sincronización de equipos de red y sus métricas: de HPE IMC a iTRACS
El crontab lanza el ETL de HPE IMC Service. Un bloqueo de ejecución impide que dos ciclos se solapen si uno se alarga.
Para cada equipo consulta en paralelo su número de serie, tipo y versión de firmware, cuenta sus puertos Ethernet totales y obtiene sus tarjetas.
Recupera las métricas de rendimiento de cada equipo (CPU, memoria, consumo eléctrico, temperatura, tráfico RX/TX, errores y descartes), clasifica cada sensor por tipo y calcula las métricas agregadas por equipo (por ejemplo, temperatura media de entrada y de salida).
HPE IMC Service pide a iTRACS Service el identificador del origen de datos HPE IMC y le envía por lotes solo los activos y métricas que han cambiado.
VOLUMEN
En cada ciclo solo viajan a iTRACS los objetos que han cambiado, en lotes de tamaño configurable.
FRECUENCIA
Ejecución batch programada, con frecuencia configurable según las necesidades del data center.
Lo que hizo la diferencia
Decisiones de diseño que no eran las obvias, y por qué las tomamos.
Clave 2: del sensor a la métrica.
En lugar de volcar en el DCiM cientos de sondas en bruto, la integración interpreta los sensores de HPE IMC, los clasifica por tipo y los consolida en un conjunto reducido de métricas por equipo que un DCiM sabe usar: % de CPU, % de RAM, consumo en W y temperatura de entrada y de salida. El dato llega listo para el análisis de capacidad y para incluir la red activa en el balance energético y térmico del data center.
Clave 1: sincronización por diferencias.
Cada equipo, sensor y métrica se guarda con una huella (hash) de su contenido. En cada ciclo se compara lo que llega de HPE IMC con lo almacenado y solo se envía a iTRACS lo que ha cambiado; los equipos que desaparecen de la red se marcan como inactivos en lugar de borrarse. Esto reduce drásticamente el número de escrituras contra el DCiM y permite aumentar la frecuencia de sincronización sin penalizar su rendimiento. Además, la ejecución es configurable: se puede sincronizar todo el inventario o solo los tipos de equipo relevantes, prescindir del conteo de puertos en los ciclos rápidos o lanzar una ejecución en seco que no escribe en el destino.
¿Hablamos de tu integración?
Cuéntanos qué sistemas tienes y qué necesitas que se hablen.